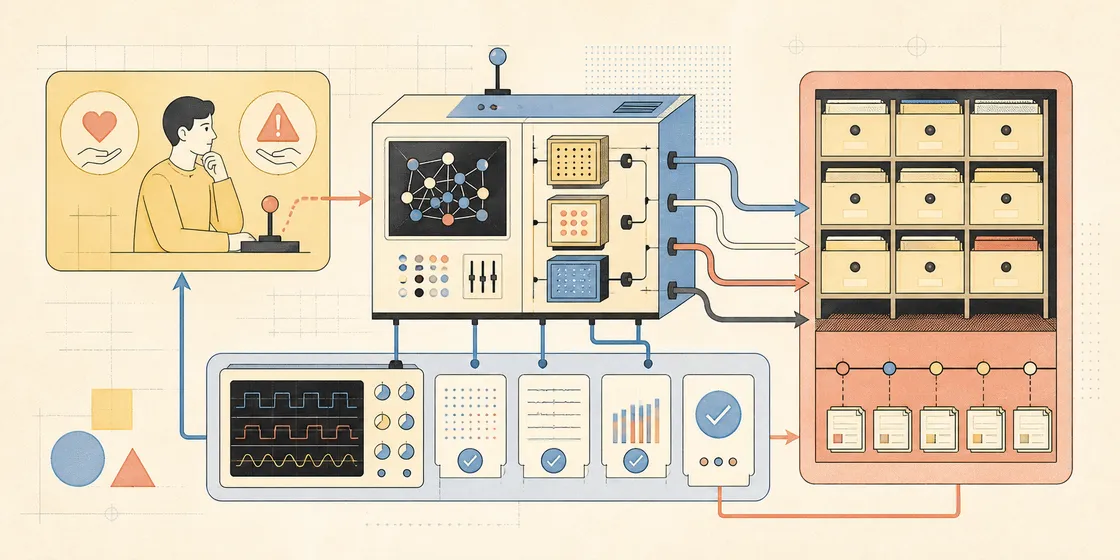
最近,我又开始重新审视自己在 Vibe Coding 下的工作方式。
前一阶段,我逐渐接受了一件过去很难接受的事情:
在不需要多人协作的项目里,我未必需要持续掌握 AI 生成的全部架构和实现细节。
如果 AI 可以快速重构代码、替换模块、改变内部数据流,而我仍然能够通过测试、契约和可观察结果判断系统是否正确,那么“理解每一个内部实现”本身可能不再是必要条件。
于是我的工作方式开始发生变化。
我不再试图持续维护完整的软件架构,而是把注意力转向:
- 验收;
- 边界;
- 不变量;
- 风险;
- 可观察结果。
AI 负责内部架构和绝大部分实现。
人负责定义什么叫正确。
这个方向一开始工作得很好。
但随着项目继续变复杂,我又遇到了一个新的问题:
如果架构可以交给 AI,而人只负责契约,那么契约本身会不会也变成新的认知债?
答案逐渐变成了:会。
而且它可能比传统架构文档膨胀得更快。
第一阶段:我试图只维护验收和边界
最开始,我的想法其实很直接。
既然 AI 可以负责:
- 代码;
- 模块拆分;
- 内部架构;
- 数据流;
- 重构;
- 实现细节;
那么我只需要掌握:
- 产品应该表现成什么样;
- 哪些场景必须通过;
- 哪些情况绝对不能发生;
- 哪些行为属于正式支持范围。
也就是说,把系统变成:
人↓验收 / 边界 / 契约↓AI↓架构 / 实现 / 重构这样看起来非常合理。
尤其是在单人负责项目时,我不需要为了多人协作去维护大量模块说明,也不需要理解每一次 AI 的内部重构。
只要最终行为正确,内部实现就可以是可抛弃的。
但很快,现实开始污染这套模型。
边界文档开始变成“问题垃圾场”
一个理想的边界可能是:
Camera Discovery 必须能够正确返回当前可用设备。
这句话非常简单。
但是进入真实开发后,很快就会出现:
- 某型号设备初始化前不会出现;
- 某 Driver 版本会重复返回;
- 某台研发电脑存在 USB Hub 问题;
- Debug 阶段暂时屏蔽虚拟设备;
- Remote Desktop 下暂时不可用;
- 某个功能只有 Release Build 才开启;
- 测试环境里为了绕过一个已知问题,需要增加特殊等待;
- 某个 Bug 当前不处理,因为只影响内部研发环境;
- 某版本兼容层存在临时 workaround。
于是原来只有一句话的边界,慢慢变成:
Camera Discovery 必须能够正确返回设备。
但是:
- DEV-PC-07 忽略重复设备问题;- Driver 3.8 存在已知兼容问题;- Debug 环境不验证 Virtual Camera;- Remote Desktop 当前不保证;- 某些机器启动后需要额外等待;- 研发阶段允许屏蔽某一类异常;……
继续维护下去之后,我发现这里已经出现了一个根本问题:
这些内容根本不是同一种东西。
它们至少包含:
- 产品正式承诺;
- 当前实现能力;
- 已知缺陷;
- 环境特例;
- 临时研发措施;
- 兼容性结果;
- workaround;
- 尚未验证的未知情况。
但是因为它们都与“边界”有关,我把它们塞进了同一个文档。
结果就是:
边界文档越来越完整,同时也越来越不可维护。
第二阶段:我尝试 Harness Engineering
为了降低这种失控,我开始进一步分层。
不再只是写文档,而是建立 Harness。
每一层负责一种稳定的能力,例如:
Core↓Windows Capability↓Observer↓Backend Adapter↓UI Adapter↓CaseAI 可以在这些能力之上组合新的测试流程。
系统的每一层也尽可能能够独立观察:
Backend↓Service↓Client↓UI当最终行为失败时,我不希望只得到一个 FAIL,而是希望看到:
Backend: PASSService: PASSClient: FAILUI: FAIL这让我逐渐把测试理解为一种:
measurement system
也就是测量系统。
Harness 不负责解释整个项目,而是负责提供可重复、可观察、可定位的证据。
这个方向解决了一部分问题。
但又带来了一个新的诱惑:
既然已经分层,是不是每一层都应该拥有自己的定义、边界、特殊情况、兼容说明和文档?
如果继续这样做,Harness 很快又会变成第二个产品。
最终我还是需要维护:
Core 文档Windows 文档Observer 文档Backend 文档UI 文档Case 文档特殊情况兼容情况已知问题临时措施于是问题又回来了。
只是这一次,从“架构复杂度”变成了“知识结构复杂度”。
我开始意识到:契约本身也会腐化
之前我认为:
AI 可以拥有架构,但不能拥有“什么叫正确”。
所以人应该长期维护契约。
这个原则仍然成立。
但现在我认为,它还缺少一个更细的拆分。
因为“契约”这个词太大了。
如果把所有下面这些东西都叫契约:
- 正式支持什么;
- 当前能做到什么;
- 哪些环境测过;
- 哪些环境失败;
- 哪些问题暂时忽略;
- 哪些 bug 已知但不修;
- 哪些功能研发阶段关闭;
- 哪些场景尚未验证;
- 哪些兼容性只是偶然跑通过;
那么契约最终一样会变成机器才能理解的大型知识库。
真正需要长期由人维护的东西,也许比“完整契约”还要更少。
从“边界”转向“承诺”
我现在认为,最重要的一次变化是:
不要维护系统全部边界,而是维护我们愿意承担责任的边界。
这两者不是一回事。
例如:
某个功能在 Windows 10 + 特定 Driver + Remote Desktop 下,当前实际上可能能够运行。
但这不代表产品必须正式承诺支持。
反过来,如果产品已经正式承诺支持 Windows 11,那么即使当前版本存在 Bug,也不能因为实现失败,就把文档改成:
Windows 11 暂不支持。
否则就会发生一种非常危险的逆向过程:
实现存在问题↓测试失败↓AI 修改边界↓把失败重新定义成“不支持”↓测试重新通过这实际上不是修复系统,而是在修改“什么叫正确”。
所以我开始把“边界”进一步收缩成:
Support Envelope
也就是:
产品明确愿意承担责任的支持范围。
例如:
Camera Discovery
正式支持:
- Windows 11- 当前正式版本与前一个正式版本- 官方 Driver- 本地用户 Session
明确不保证:
- Remote Desktop- 虚拟 Camera- 非官方 Driver
到这里就应该结束。
不要继续把所有现实世界里的临时问题都追加进去。
软件其实存在两种不同的 Truth
过去我一直在寻找一个稳定的 Source of Truth。
后来我发现,很多混乱恰恰来自于:
我试图让同一个东西同时表达两种完全不同的真相。
第一种是:
Normative Truth
也就是:
系统应该是什么。
例如:
- 我们承诺支持 Windows 11;
- 用户数据不能被静默删除;
- 一个 Tenant 不能访问另一个 Tenant 的数据;
- 已确认的历史记录不能被修改;
- 某个 API 必须保持兼容;
- 某项操作失败后必须可恢复。
这些是:
- 产品承诺;
- 业务规则;
- 不变量;
- 安全边界;
- 数据保证;
- 兼容保证。
它们不应该随着某一次实现问题而自动变化。
第二种是:
Descriptive Truth
也就是:
系统现在实际上是什么。
例如:
- Build 143 在 Windows 11 上是否真的通过;
- 当前 Driver 4.31 是否兼容;
- 某个 Feature Flag 当前是否开启;
- 某条内部调用链现在经过哪些模块;
- 当前版本是否存在已知 Crash;
- 某环境是否需要 workaround。
这些不是产品承诺。
它们描述的是当前现实。
而当前现实应该主要由这些东西决定:
代码运行状态测试Trace配置生产观测AI 可以负责读取和整理这些事实。
当 SHOULD 和 IS 不一致时,不要强行同步
假设:
Normative Truth:Windows 11 必须支持。
Descriptive Truth:当前 Build 在 Windows 11 上失败。
正确的结果应该是:
BUG而不是:
修改边界文档:Windows 11 暂不支持。这让我开始接受一个过去不太习惯的状态:
系统应该是什么,与系统现在是什么,可以暂时不一致。
这种不一致本身就是有价值的信息。
不应该为了让文档看起来“永远一致”,把差异抹掉。
不再要求工程师知道所有边界
这里还有另一个让我犹豫很久的问题。
如果内部架构和大量细节都交给 AI,那么客户突然问:
XX 场景可不可行?
工程师很可能根本不知道。
在传统软件开发里,一个长期负责系统的工程师往往可以凭经验回答很多问题。
但在 AI 高速修改系统之后,这种能力会快速下降。
我最开始认为:
这是不是说明 AI 开发已经造成严重失控?
后来我逐渐认为,不一定。
真正的问题不是:
工程师有没有把所有 edge case 记在脑子里。
而是:
当工程师不知道的时候,系统能不能提供可信证据。
例如 AI 不应该回答:
看代码应该可以。
而应该回答:
状态:VERIFIED
Build:2.8.143
Environment:Windows 11 24H2Driver 4.31
Evidence:CASE-CAMERA-041CASE-CAMERA-087
Last verified:2026-08-08
Formal Support:NO
这时候 AI 的角色不再是:
知识权威。
而是:
证据检索器。
这两者差别很大。
“能不能运行”不应该只有 Yes / No
现实中的支持状态其实不是 Boolean。
它至少应该存在几个不同级别:
GUARANTEED
产品正式承诺支持。失败属于产品缺陷。
VERIFIED
当前版本在某个明确环境中验证通过,但不一定属于正式支持承诺。KNOWN LIMITATION
已经知道当前版本在该场景存在问题。UNSUPPORTED
明确不属于产品支持范围。UNKNOWN
没有足够证据判断。这样一来,客户问:
Windows 11 + 4K Camera + Remote Desktop 能不能用?
答案就不再需要伪装成绝对确定:
Formal Support:UNSUPPORTED
Current Evidence:Build 2.8.143 曾在类似环境运行通过 3 次。
Conclusion:当前存在成功运行证据,但产品不对该组合提供正式保证。
这比工程师凭记忆说:
应该可以吧。
可靠得多。
特殊情况不应该进入承诺层
很多文档失控,就是因为“特殊情况”全部进入了长期边界。
现在我认为,这些特殊情况应该被独立建模。
例如:
DEV-PC-07 上暂时忽略 Camera Discovery 的某个 Bug。
它不是产品边界。
它应该是:
type: environment_exception
scope:  machine: DEV-PC-07
issue: CAMERA-142
effect:  ignore_failure: CameraDiscovery
reason:  defective_usb_hub
expires:  2026-09-01
再例如:
研发阶段暂时屏蔽 Virtual Camera。
它应该是:
type: temporary_guard
scope:  stage: development
feature:  VirtualCamera
reason:  implementation_incomplete
expires:  before_release: true
issue:  FEATURE-183
这些东西可以很多。
甚至可以由 AI 自动维护。
但是它们不应该污染产品正式承诺。
临时例外必须允许被遗忘
这又让我意识到一个很容易被忽略的问题:
AI 工程中的遗忘机制,可能和记录机制一样重要。
人类看到一条两年前的临时 workaround,往往会本能地觉得:
这个东西是不是已经过时了?
AI 不一定。
如果没有明确状态,它可能非常忠实地继续把旧内容当成现实的一部分。
所以任何:
- 临时屏蔽;
- 开发环境特例;
- 测试豁免;
- workaround;
- 临时兼容层;
- 某设备特殊规则;
都应该尽量包含:
scopereasonissueintroduced_atexpiry没有 expiry 的 temporary exception,最终很容易变成永久知识污染。
那人还需要掌握架构吗?
走到这里以后,另一个问题又回来了:
如果工程师既不掌握所有 edge case,也不掌握全部内部架构,那是不是退让太多了?
我目前的答案仍然是:
不需要重新掌握全部 Implementation Architecture。
但人必须掌握另一种架构:
Risk Architecture
也可以叫:
Irreversibility Map
人未必需要知道:
CameraService↓DeviceResolver↓Win32Provider↓CacheProvider这些东西 AI 可以随时重构。
但人应该知道:
设备发现↓生成稳定 Device Identity↓写入持久化配置↓客户配置引用 Device ID因为这里开始出现不可随意修改的现实:
- Device ID 能不能改变?
- 历史配置还能不能读取?
- 旧客户端是否仍然兼容?
- 数据迁移失败以后怎么办?
- 已经写出去的状态能不能恢复?
- 外部系统是否已经引用了这个值?
这些才是人真正值得长期掌握的结构。
可重写的结构,与不可逆的现实
我现在倾向把系统分成两部分:
┌──────────────────────────────┐│ 可自由重写                    ││                              ││ internal algorithm           ││ class hierarchy              ││ service layout               ││ cache strategy               ││ internal framework           │└──────────────────────────────┘
               ↓
┌──────────────────────────────┐│ 人必须关注                    ││                              ││ Persistent Data              ││ Identity                     ││ External API                 ││ Security Boundary            ││ Side Effects                 ││ Compatibility                ││ Migration                    ││ Recovery                     │└──────────────────────────────┘
上面那部分可以让 AI 高频调整。
下面那部分一旦变化,人就应该知道。
因为 AI 可以在一天内重写十万行代码,但无法撤回已经发生的现实。
Harness 的职责也需要重新限定
Harness Engineering 仍然是我目前非常认可的方向。
但现在我会给它一个更严格的定义:
Harness 是 measurement system,不是 knowledge system。
它的目标不是:
完整描述系统。
而是让系统能够回答问题。
例如:
Can Camera A be discovered?
Can old configuration survive migration?
Does UI state equal backend state?
Can this workflow recover after restart?
Does retry create duplicate side effects?
Harness 只需要持续产生高质量证据。
不需要承担所有历史知识、产品承诺和特殊情况。
否则 Harness 本身会重新变成另一个需要维护的大型系统说明书。
我现在倾向于只长期维护四类资产
经过这几轮变化,我越来越不希望项目里存在十几份“需要长期正确”的文档。
更合理的状态可能只有四类。
1. Human Guarantee Surface
这是人真正拥有的部分。
它应该非常小。
只记录:
- 我们承诺什么;
- 我们明确不支持什么;
- 什么绝对不能发生;
- 什么数据不能丢;
- 哪些兼容性必须保证;
- 哪些产品行为未经人工批准不得改变。
一个非常重要的约束是:
项目负责人必须能够在较短时间内重新读懂这部分内容。
如果这一层已经出现几千条特殊规则,说明它已经失去意义。
2. Risk / Irreversibility Map
这也是人拥有的。
它描述:
- 持久化数据;
- Identity;
- 外部 API;
- 权限边界;
- 不可逆副作用;
- 数据迁移;
- 兼容关系;
- 故障恢复;
- 已经发生的外部承诺。
它不需要描述每一个内部模块。
它只需要告诉人:
哪些地方一旦改错,AI 不能靠“重新生成代码”解决。
3. Machine Reality
这一层允许非常大。
由 AI、代码分析、运行状态和工具共同维护。
例如:
- 当前架构;
- 当前 Capability;
- Feature Flag;
- Known Issue;
- Environment Exception;
- Temporary Guard;
- Compatibility Result;
- 当前内部数据路径;
- 运行时 Observation;
- Trace 索引。
这部分未来很可能完全不适合人直接阅读。
我认为这不是失败。
它本来就可以成为:
AI-interpretable project memory
也就是机器可消费的项目现实模型。
4. Evidence
Evidence 主要由 Harness 产生。
例如:
CASE-041 PASSBuild 143Windows 11 24H2Driver 4.312026-08-08或者:
Migration V12 → V13Dataset: production-snapshot-20260801Result: PASSRollback: PASSAI 在回答现实问题时,应该尽量回到 Evidence。
而不是根据一段长期维护的自然语言文档做推测。
最终结构
整个体系开始变成:
                    Human
          ┌──────────────────────┐          │ Guarantee Surface    │          │ Risk / Irreversibility│          └──────────┬───────────┘                     │              defines SHOULD                     │                     ▼          ┌──────────────────────┐          │        System        │          │   AI Implementation  │          └──────────┬───────────┘                     │                  Harness                     │                     ▼          ┌──────────────────────┐          │ Evidence / Trace     │          └──────────┬───────────┘                     │                     ▼          ┌──────────────────────┐          │   Machine Reality    │          └──────────┬───────────┘                     │                     ▼                    AI                     │                     ▼              Human asks questions
这里有一个很大的变化:
人不再维护“系统全部知识”。
人维护的是:
承诺风险裁决权AI 维护的是:
当前现实内部结构大量细节Harness 维护的是:
证据历史系统维护的是:
过去发生过什么AI 即时生成文档,不一定是退化
以前我会认为:
如果工程师每次都要问 AI 才知道系统怎么运行,说明项目已经失控。
现在我不再完全这样看。
如果 AI 只是根据旧文档做语言推测,当然危险。
但如果 AI 是:
读取当前系统+查询 Evidence+读取正式 Support Envelope+结合 Risk Map然后生成一次即时解释,那么这更像:
Query / Projection
而不是:
临时编一份文档。
这种文档本身甚至不需要长期保存。
例如:
“当前版本对 Windows 11 + Driver 4.31 的 Camera Discovery 支持情况如何?”
AI 可以即时生成一份报告。
下一次版本变化后,再重新查询。
长期保存的应该是:
- 正式承诺;
- 证据;
- 运行事实;
- 风险;
- 历史。
而不是每一次给人看的自然语言解释。
工程师的职责也可能因此改变
传统软件工程里,一个长期负责项目的好工程师,往往意味着:
他脑子里拥有大量系统知识。
但 AI Native 工程里,这个定义可能需要改变。
未来更重要的能力也许是:
知道什么可以承诺,什么不能承诺,以及如何取得可信证据。
工程师不需要记住 500 个 edge case。
但必须清楚:
什么是产品承诺?什么只是当前实现?什么只是一次测试结果?什么属于已知缺陷?什么还没有验证?什么允许 AI 自动修改?什么必须人工批准?这更像一种:
Authority Model
而不是完整系统记忆。
从 Contract-Driven 再往前一步
我之前逐渐接受:
不再拥有架构,只拥有契约。
现在我认为,这句话还可以继续收缩:
甚至不要试图长期拥有全部契约。
更准确的表达可能是:
人拥有承诺、风险和最终裁决权。
AI 拥有:
内部现实和实现细节。
Harness 拥有:
可重复的证据。
Version Control、Issue、日志和生产数据拥有:
历史。
这四种东西不应该再被强行压进同一份文档。
Promise / Reality Separation
我现在越来越觉得,这个模式真正的核心不是“怎样把 AI 文档维护得更好”。
而是:
永远不要再试图用同一份文档同时表达:
- 我们承诺什么;
- 系统现在是什么;
- 历史上发生过什么;
- 当前有哪些临时问题。
这四种信息的生命周期完全不同。
强行同步它们,只会制造认知债。
如果把它们分开:
Promise↓人负责
Reality↓AI / Runtime 负责
Evidence↓Harness 负责
History↓Version Control / Issue / Log 负责
那么很多原本需要“维护文档”解决的问题,会自然变成不同系统之间的职责划分。
这也许可以叫 Evidence-Backed AI Engineering
如果继续沿着这个方向发展,我目前更愿意把它理解为一种:
Evidence-Backed AI Engineering
它不要求人长期理解系统的每一个内部细节。
也不要求 AI 永远维护一份完美、无冲突、完整可读的知识文档。
它要求的是:
- 人明确产品愿意承诺什么;
- 人知道哪些现实状态不可逆;
- AI 可以自由修改内部实现;
- Harness 持续生产确定性证据;
- 当前现实允许由 AI 重新提取;
- 未知必须保持 UNKNOWN;
- 临时例外必须能够过期;
- 实现失败不能自动变成产品边界;
- 最终所有外部结论都能够追溯到承诺或证据。
目前的结论
这仍然不是一个最终答案。
我现在只是越来越确定:
AI 时代真正的问题已经不是代码生成速度,而是认知所有权如何重新分配。
传统软件工程默认:
工程师=需求理解+架构理解+实现理解+边界理解+历史理解+故障理解但当 AI 的实现速度远远超过人的认知吞吐量以后,这个模型可能无法继续成立。
新的模型也许会变成:
Human=Promise+Risk+Judgement
AI=Implementation+Current Reality+Explanation
Harness=Evidence
History System=Past
这样,人并没有放弃系统控制权。
人放弃的是:
对所有内部细节的持续占有。
而真正保留下来的,是:
定义什么值得保证、什么损失不可接受,以及什么证据足以让我相信系统仍然正确。
我目前正在沿着这个方向继续实践。
它很可能还会暴露新的问题。
但至少现在,我开始觉得:
下一阶段真正需要被设计的,不再只是软件架构,而是人、AI、运行系统和证据之间的权力边界。